czy bezpiecznie wgrać CV do ChatGPT
Czy bezpiecznie jest wgrać CV do ChatGPT?
Wklejenie CV do ChatGPT nie jest lekkomyślne, ale nie jest też obojętne. Oto co dzieje się z plikiem, jedno ustawienie, które naprawdę zmienia odpowiedź, i jak uzyskać tę samą pomoc, nic nie wysyłając.
Krótka odpowiedź: zwykle nie jest to niebezpieczne i nigdy nie jest obojętne. Twoje CV to najgęstszy zbiór danych osobowych, jaki posiadasz, a wklejenie go do okna czatu zostawia kopię w miejscu, nad którym nie masz już kontroli.
To nie czyni z ChatGPT złego narzędzia. Czyni z niego narzędzie z warunkami, które warto przeczytać raz, zanim zastosuje się je do najbardziej wrażliwego dokumentu w poszukiwaniu pracy. Ten artykuł wyjaśnia, co naprawdę dzieje się z plikiem, które ustawienie najmocniej zmienia odpowiedź, co zawiera CV, czego nie ma zwykły dokument, i jak uzyskać to samo dopasowanie bez wysyłania.
Co naprawdę zawiera CV
Traktujemy CV jak dokument zawodowy. Dla prawnika od ochrony danych to dossier. Jeden plik zawiera zwykle Twoje pełne imię i nazwisko, adres domowy, prywatny numer telefonu, prywatny e-mail, każdego pracodawcę i każdą datę z dekady, wykształcenie, a często również zdjęcie i datę urodzenia.
W niepowołanych rękach to wystarczy do przekonującej kradzieży tożsamości i do ukierunkowanego phishingu, który wymienia nazwisko Twojego prawdziwego przełożonego. W UE część z tego może też podpadać pod artykuł 9 RODO, na przykład jeśli CV wspomina o działalności związkowej, przerwie zdrowotnej albo wolontariacie religijnym.
To jest prawdziwy powód, by się zatrzymać. Nie dlatego, że ChatGPT jest złośliwy, ale dlatego, że plik jest wart więcej, niż na to wygląda.
Ustawienie, które zmienia odpowiedź
Najważniejszy fakt o ChatGPT i Twoich danych jest taki, że odpowiedź zależy od produktu, a prawie nikt nie wie, którego używa.
W planach konsumenckich, Free i Plus, OpenAI może wykorzystywać Twoje rozmowy do ulepszania modeli, dopóki tego nie wyłączysz. Ustawienie znajduje się w Ustawieniach, w sekcji kontroli danych. Wyłączenie nie usuwa tego, co już wysłałeś, więc warto je zmienić przed wklejeniem CV, a nie po.
W API oraz w planach Team i Enterprise domyślnie jest odwrotnie: treści nie są używane do trenowania, chyba że sam się na to zgodzisz. OpenAI podaje, że dane wejściowe i wyjściowe API są przechowywane przez ograniczony czas na potrzeby kontroli nadużyć, a potem usuwane, o ile prawo nie wymaga inaczej.
To rozróżnienie decyduje o wszystkim i jest niewidoczne z poziomu okna czatu. Ten sam model, osiągnięty dwiema drogami, przychodzi z dwiema różnymi domyślnymi odpowiedziami na temat Twojej kariery.
Ten sam podział dotyczy wszystkich asystentów
To ChatGPT pojawia się w wyszukiwaniach, ale nic z tego nie jest specyficzne dla OpenAI. Wszyscy duzi asystenci działają na tych dwóch poziomach, a poziom znaczy więcej niż marka.
| Asystent | Domyślnie, aplikacja konsumencka | Domyślnie, API dla deweloperów |
|---|---|---|
| ChatGPT (OpenAI) | Może używać rozmów do ulepszania modeli, o ile nie wyłączysz tego w kontroli danych | Nie jest używane do trenowania |
| Gemini (Google) | Recenzenci mogą czytać wybrane rozmowy; retencję określają ustawienia aktywności | Nie jest używane do trenowania |
| Claude (Anthropic) | Domyślnie nie jest używane do trenowania | Nie jest używane do trenowania |
| Grok (xAI) | Dane konsumenckie mogą służyć do trenowania; sprawdź ustawienie konta | Nie jest używane do trenowania |
| Perplexity | Przechowuje wyszukiwania i wątki; ustawienie konta reguluje użycie do trenowania | Nie jest używane do trenowania |
Wynikają z tego dwie rzeczy. Po pierwsze, to plan konsumencki skupia całą niejednoznaczność u wszystkich, więc pytanie „czy to bezpieczne” dotyczy zwykle tego, którymi drzwiami weszłeś, a nie którą firmę wybrałeś. Po drugie, API jest konsekwentnie surowszym ustawieniem, czyli odwrotnie, niż zakłada większość ludzi.
Polityki się zmieniają, więc potraktuj tabelę jako zachętę do sprawdzenia, a nie jako trwały fakt. Pytanie do wyszukania jest zawsze to samo: czy ten produkt domyślnie używa moich danych do trenowania i gdzie jest to ustawienie.
Trzy ryzyka, które mają znaczenie
Trenowanie. Jeśli Twoja rozmowa może posłużyć do ulepszania modelu, Twoja historia zawodowa staje się częścią zbioru treningowego. W praktyce ryzyko, że model wyrecytuje obcej osobie Twój adres, jest niskie, ale nie zerowe. To akurat masz w pełni pod kontrolą dzięki ustawieniu powyżej.
Przechowywanie i przegląd przez człowieka. Nawet przy wyłączonym trenowaniu rozmowy są zapisywane. Dostawcy sprawdzają próbki pod kątem nadużyć i bezpieczeństwa. To rozsądne z ich strony i nadal oznacza, że człowiek może przeczytać to, co wysłałeś.
Przejęcie konta i wycieki. To ryzyko jest najbardziej niedoceniane. Twoja historia rozmów jest prywatna tylko na tyle, na ile mocne jest Twoje hasło. Powtórzone hasło w serwisie AI odsłania teraz dekadę historii zatrudnienia, a nie tylko jedną rozmowę.
Co jest w porządku, a co nie
Nie wszystko wymaga całego pliku. Uczciwy podział wygląda tak.
- W porządku: poprosić o lepsze sformułowanie jednego punktu, sprawdzić, czy zdanie brzmi biernie, wygenerować pytania rekrutacyjne z publicznego ogłoszenia, poprosić o wyjaśnienie nieznanej nazwy stanowiska.
- Warto się zastanowić: wklejenie pełnej historii zatrudnienia z pracodawcami i datami, nawet bez danych kontaktowych.
- Lepiej unikać: wgrywania gotowego PDF-a z adresem, telefonem i datą urodzenia na koncie z włączonym trenowaniem modeli.
Jeśli i tak z tego korzystasz, najpierw zamaskuj dane
Większość wartości tkwi w treści, nie w identyfikatorach. Możesz usunąć zaskakująco dużo, nic użytecznego nie tracąc.
- Zastąp swoje imię i nazwisko oznaczeniem, na przykład „kandydatka”.
- Usuń całkowicie adres, telefon i datę urodzenia. Żadna porada dotycząca CV od nich nie zależy.
- Zamień nazwy pracodawców na opisy, na przykład „40-osobowa agencja”, chyba że marka jest właśnie sednem.
- Zostaw osiągnięcia, liczby i daty. Tego model potrzebuje, żeby być przydatny.
Zamaskowane CV daje mniej więcej tę samą jakość informacji zwrotnej przy ułamku ekspozycji. Zajmuje to około dwóch minut.
Alternatywa: ten sam model, inne warunki
Jest trzecia możliwość, o której mało kto myśli, bo rynek zbudowano wokół narzędzi w przeglądarce. Możesz uruchomić dopasowanie na własnym komputerze i sięgnąć do modelu własnym kluczem API.
Ta jedna zmiana przenosi Cię z warunków konsumenckich na warunki API, gdzie treści domyślnie nie służą do trenowania, u dowolnego dostawcy. Usuwa też bazę danych pośrodku: żaden kreator CV nie trzyma kopii Twojego pliku, bo plik nigdy nie opuszcza komputera.
Tak działa CVumi. To aplikacja desktopowa na Windows i macOS. Twój profil główny, dokumenty i wcześniejsze aplikacje leżą w folderze, który wybierasz na swoim komputerze. Gdy uruchamia się krok AI, zapytanie idzie z Twojego komputera do dostawcy pod Twoim własnym kluczem i wraca. Żaden serwer CVumi nie przechowuje Twojego CV, bo na tej drodze w ogóle nie ma serwera CVumi.
Dostawcę wybierasz Ty: Anthropic, OpenAI, Google, xAI lub Perplexity. Nie jesteś przywiązany do warunków, cennika ani awarii jednej firmy, a jeśli któraś zmieni politykę, która Ci się nie podoba, zmieniasz klucz, a nie narzędzie. To płatność jednorazowa: 69 EUR za licencję standardową na trzy urządzenia albo 34 EUR z adresem uczelnianym, plus to, co Twój dostawca policzy za faktycznie zużyte tokeny.
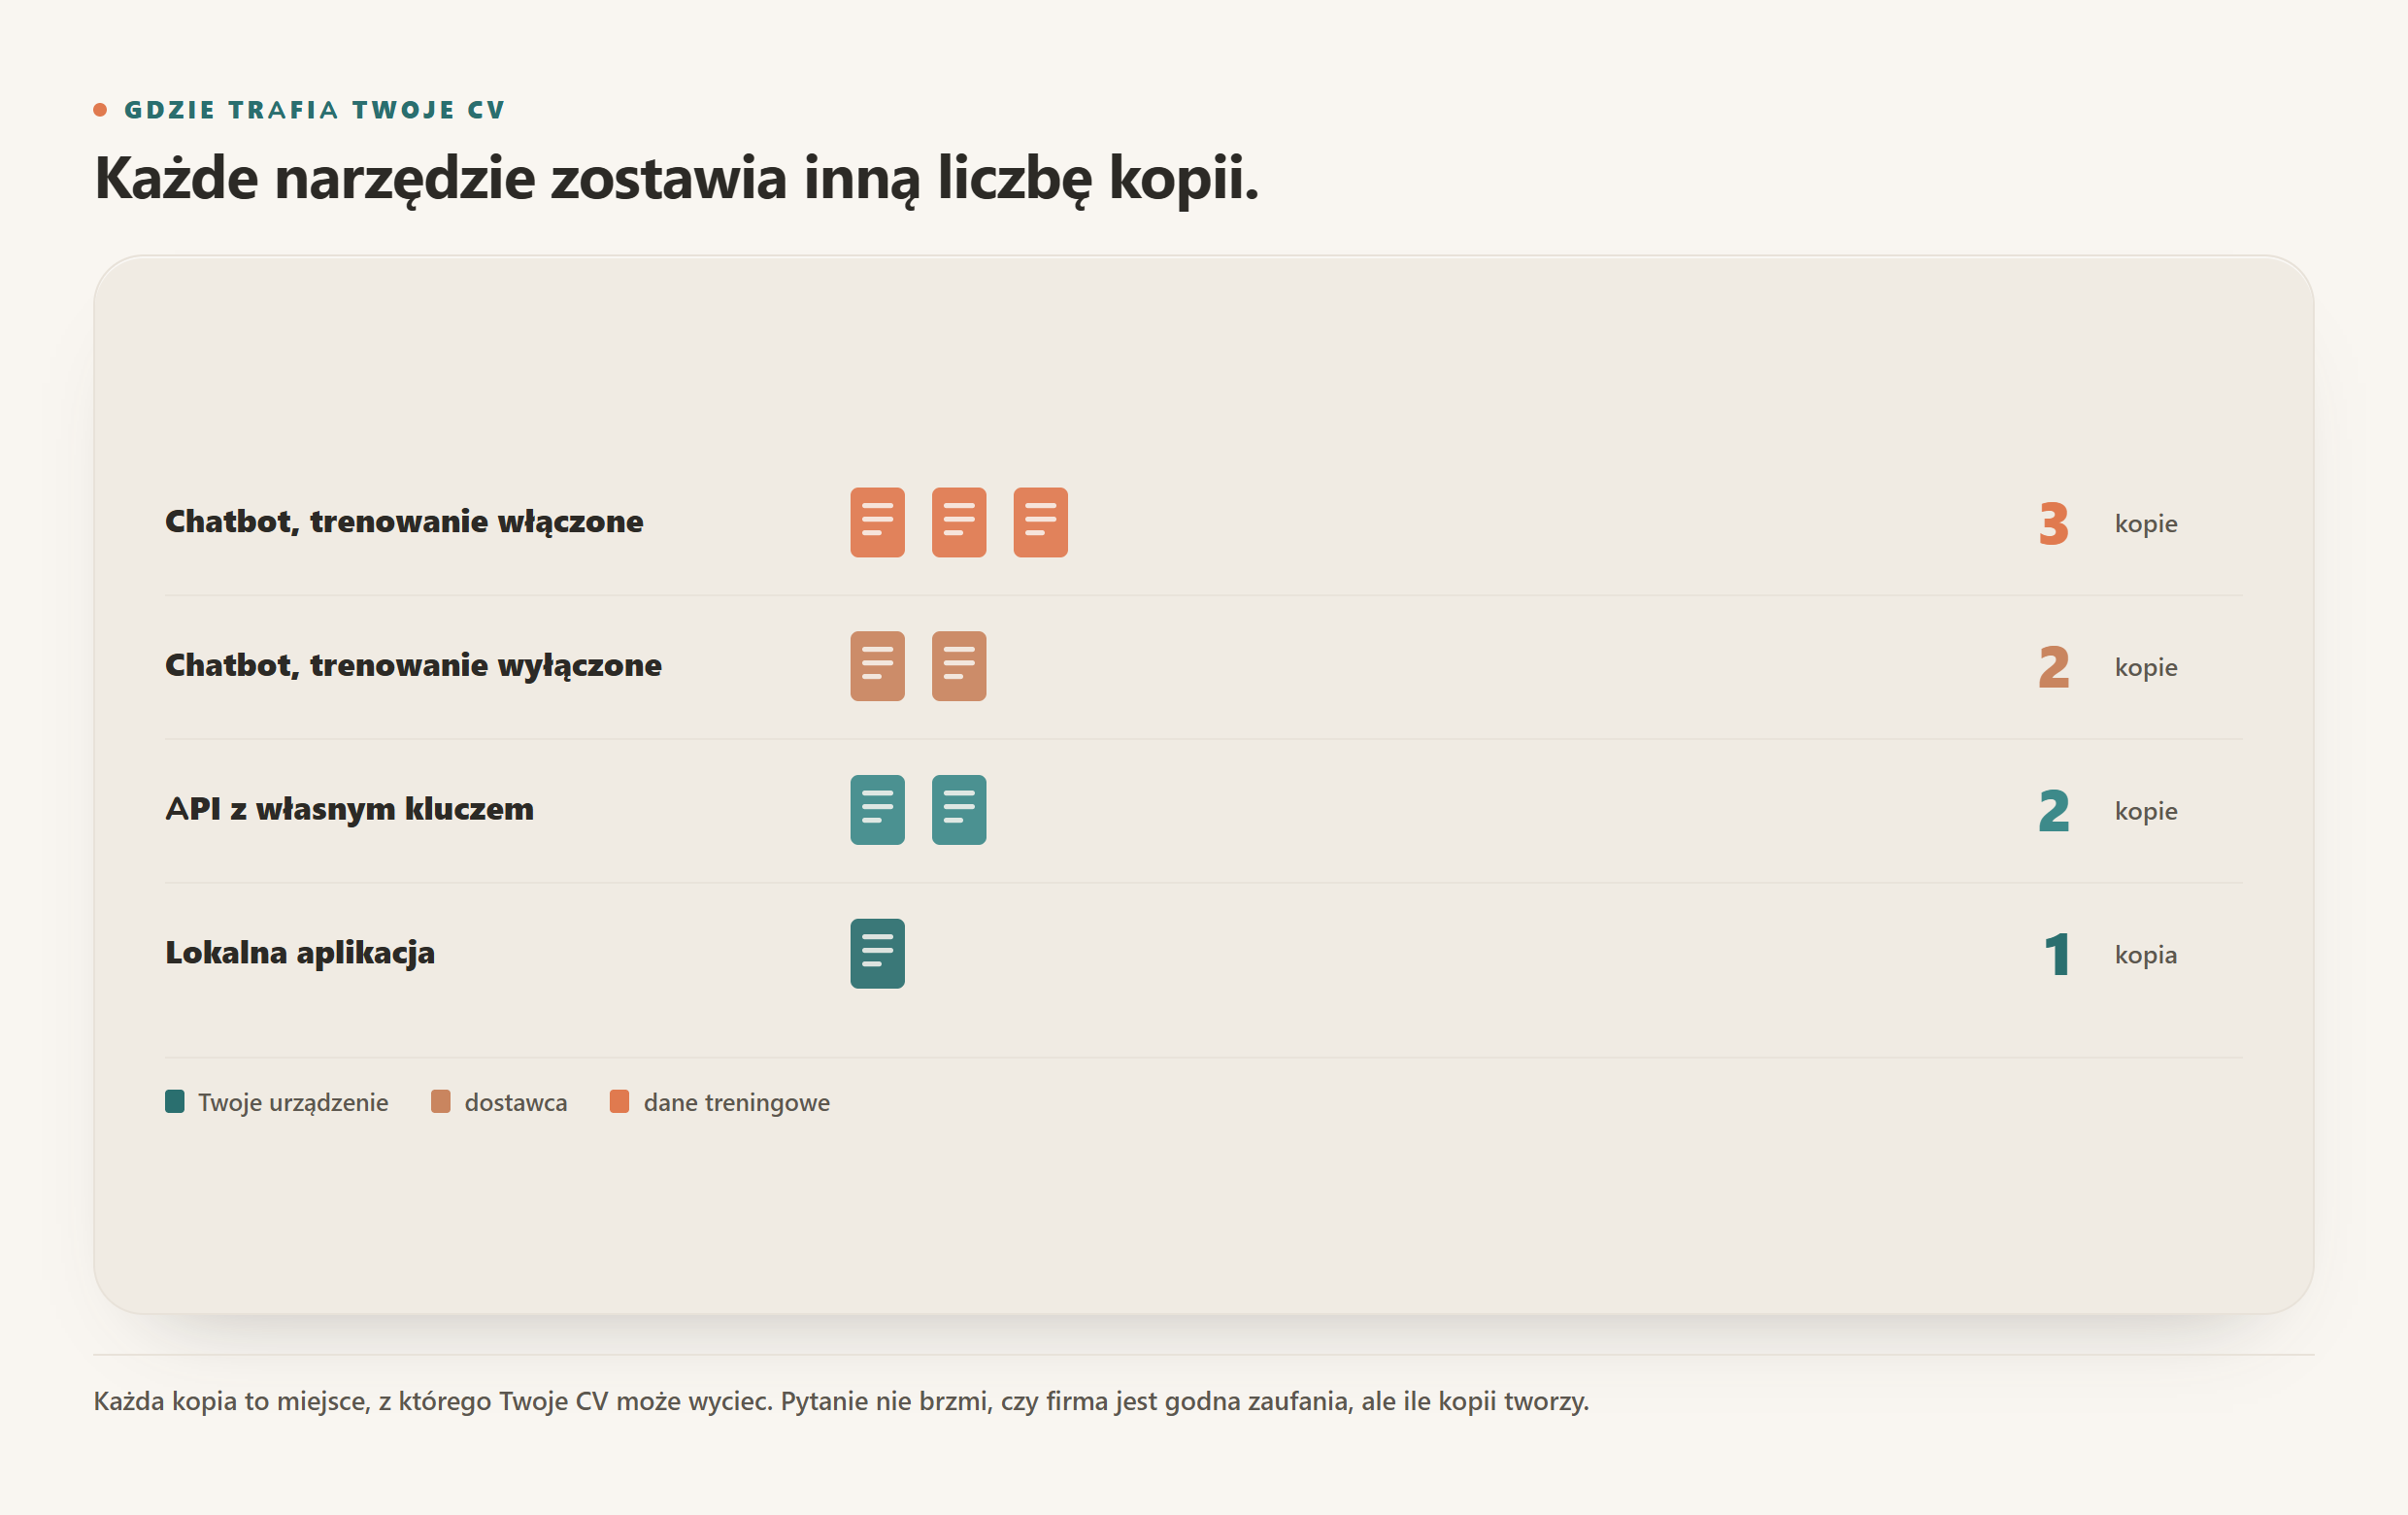
| Gdzie pracujesz | Kto ma kopię | Domyślnie używane do trenowania | Ile płacisz |
|---|---|---|---|
| Chatbot, trenowanie włączone | Ty i dostawca | Tak, o ile tego nie wyłączysz | Za darmo lub abonament |
| Chatbot, trenowanie wyłączone | Ty i dostawca | Nie | Za darmo lub abonament |
| Kreator CV w chmurze | Ty, narzędzie i jego dostawca modelu | Zależy od dwóch polityk, nie jednej | Zwykle abonament |
| Lokalna aplikacja z Twoim kluczem | Ty | Nie, obowiązują warunki API | Jednorazowa licencja plus Twoje tokeny |
Uczciwy wniosek
Wgranie CV do ChatGPT nie jest błędem. Zrobienie tego bez wiedzy, w którym planie się jest, z włączonym trenowaniem modeli i z niezamaskowanym PDF-em, w którego nagłówku widnieje adres domowy, to część, którą warto naprawić.
Jeśli zmienisz dziś tylko jedną rzecz, otwórz kontrolę danych i wyłącz trenowanie modeli przed następną sesją. Jeśli zmienisz dwie, przestań wgrywać plik i pracuj tam, gdzie i tak już leży.
Szerszy obraz znajdziesz w tekstach czy kreatory CV z AI są bezpieczne oraz jak zachować pełną prywatność dokumentów aplikacyjnych.